「AI エージェントに記憶を持たせたけれど、何を書けばいいのか分からない」「同じ失敗をしないように、失敗と禁止事項を書き溜めている。でも本当に効いているのか分からない」。AI エージェントを毎日の業務で使っていると、こうした悩みにぶつかります。
この記事では、AI エージェントの記憶について、論文の実験結果をもとに「何を書くか」「何を書かないか」を5つのルールと1行のテンプレートにまとめます。結論から言うと、失敗と禁止事項だけを書く記憶は、おすすめできません。
アストラルコードでは、複数の AI 社員(AI エージェント)が定期業務やチャットで毎日働く社内基盤を、自社で運用しています。2026年10月、AI 社員全員分の記憶 757 行を数え直し、査読つきの論文を中心に根拠を集めて、記憶の書き方を決め直しました。この記事はそのときの記録をもとに書いています。
「失敗と禁止事項だけ」の記憶は、なぜうまくいかないのか
失敗だけを書く記憶がうまくいかないのは、AI が学べるのは「失敗の記録」ではなく「成功と失敗を比べて抜き出した教訓」だからです。失敗の記録をそのまま溜めると、かえって成績が下がった実験もあります。
成功と失敗の両方から作った教訓が、いちばん効いた
教訓は、成功と失敗の両方から作るのがいちばん効きます。
Google のチームが ICLR 2026 で発表した ReasoningBank は、AI エージェントが作業を終えるたびに、その結果から教訓を抜き出して記憶に足していく方式です。教訓は「タイトル・一行の説明・本文」の短い形にまとめます。
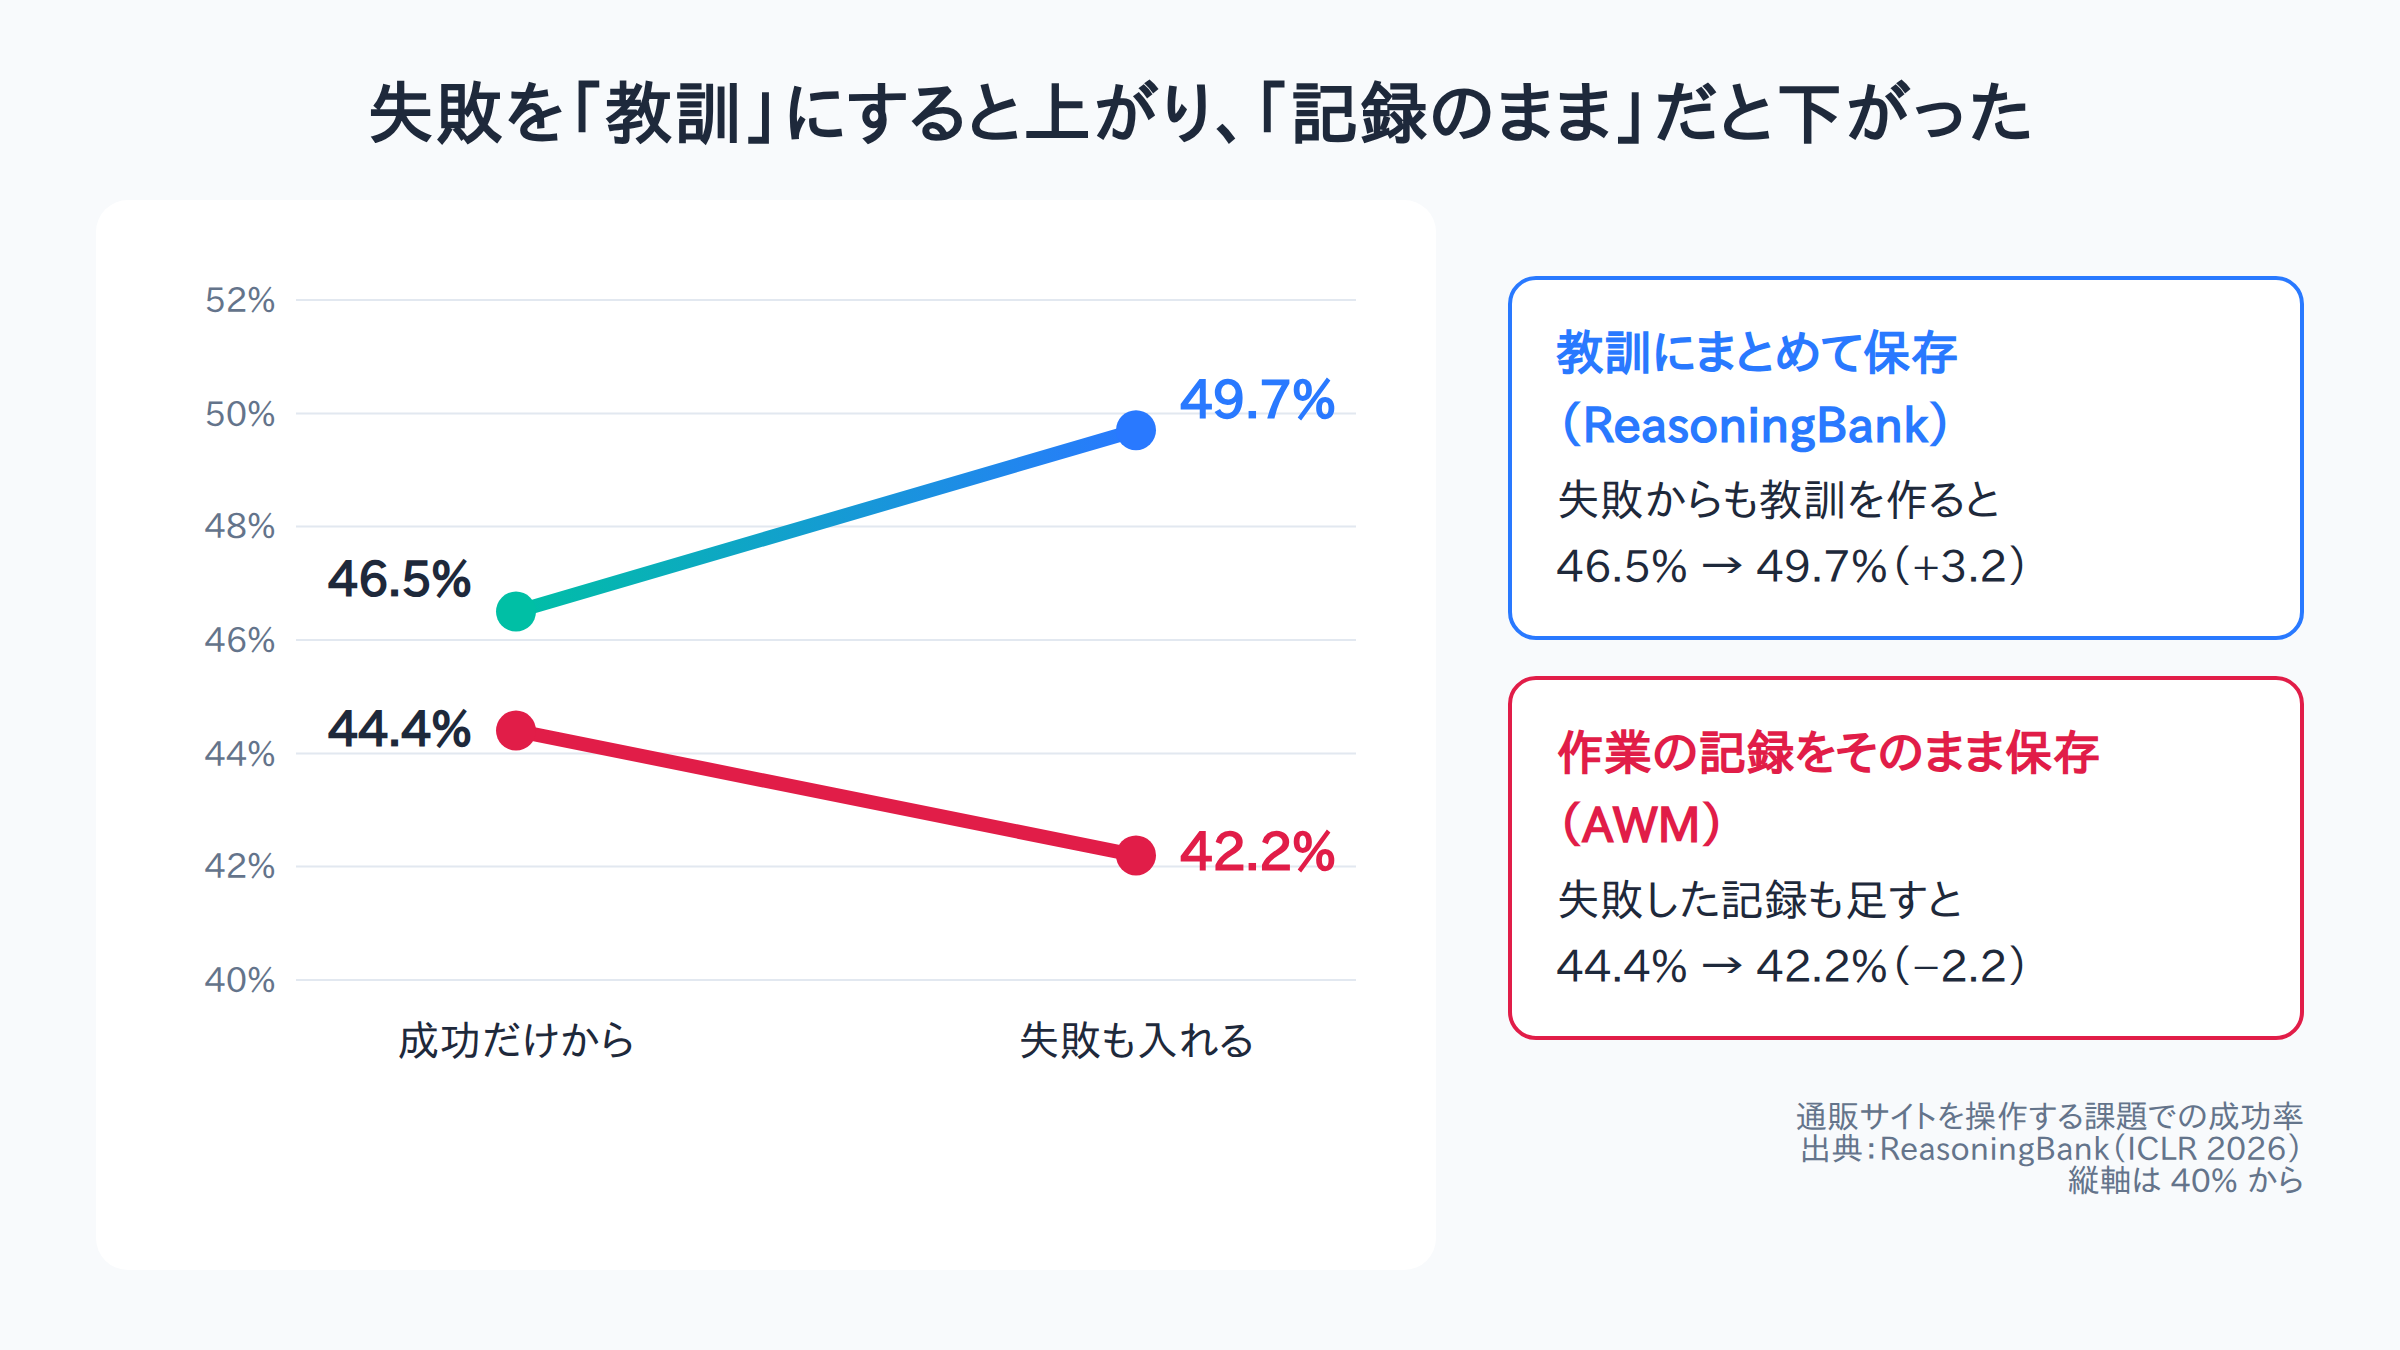
この論文では、通販サイトを操作する課題(WebArena-Shopping)で、成功した作業だけから教訓を作ると成功率 46.5%、失敗した作業からも教訓を作ると 49.7% でした(モデルは Gemini 2.5 Flash)。失敗からは「この条件でこれをすると失敗する」という注意を抜き出せるので、成功例だけより情報が増えます。
失敗は捨てずに使います。ただし、成功と並べて教訓にしてから使います。
失敗の記録をそのまま溜めると、成功率は下がった
失敗を「起きたことの記録」のまま記憶に入れると、成績は下がります。
同じ実験で、作業の手順をほぼそのまま保存する方式(AWM)も比べています。こちらは失敗した作業を記憶に足すと、成功率が 44.4% から 42.2% に下がりました。失敗した手順を手本と取り違えて、同じ失敗をなぞってしまうためと考えられます。
つまり、同じ「失敗を記憶に入れる」でも、要点を抜き出した教訓にすれば上がり、記録のまま入れると下がります。差を生むのは、失敗を入れるかどうかではなく、どういう形で入れるかです。
失敗は「起きたこと」ではなく「次にどうするか」の形にしてから記憶に入れます。
常に読ませるルールは「〜しない」型が効く。ただし根拠は1本だけ
毎回必ず読み込ませるルール(Claude Code の CLAUDE.md など)に限っては、「〜しない」型を中心にするのがよさそうです。
AWS のチームが Claude Code を5,000回以上動かして比べた研究(Guardrails Beat Guidance)では、単独で効いたルールはすべて「〜しない」型で、単独で害になったルールはすべて「〜する」型でした。
ただし、これは査読前の論文1本だけの結果です。しかも比べたのは、効いたルール3本と害になったルール4本だけで、著者自身も「示唆にとどまる」と書いています。同じ研究で「中身がランダムなルールでも同じくらい効いた」という結果も出ており、効いた理由が中身なのか、何か書いてあること自体なのかは分かっていません。そこで私たちは、これを強い根拠としては扱わず、「常に読むルールは短く、禁止を中心に」という程度にとどめました。
「〜しない」型が向くのは常に読ませる短いルールだけで、記憶全体を禁止事項で埋める理由にはなりません。
論文に基づいて決めた、記憶のルール5つ
根拠を集めた結果、記憶の書き方を次の5つに決めました。
- 記憶には「何が正しいか(事実)」を書く。「どうやるか(手順)」はスキルに書く。
- 失敗と禁止事項「だけ」にはしない。教訓は成功と失敗の両方から作る。
- 覚えるのは「オーナーの好みと決定」「コードや説明書からは分からない運用の事実」「置き換わった事実(日付つき)」の3つだけ。
- 毎回は書かない。結果が分かってから書く。
- AI が自分で作った記憶やスキルは、確かめるまで下書きにする。
根拠には、査読つきの学会(ICLR・ACL)で採択され、対照実験がある論文を優先して使いました。査読前の論文は、複数のモデルで数千回規模の実験をしたものに限り、1本だけで決めたところはそう書いています。2のルールは前の章で説明したので、ここでは残りの4つを説明します。
記憶には「何が正しいか」を書き、手順はスキルに分ける
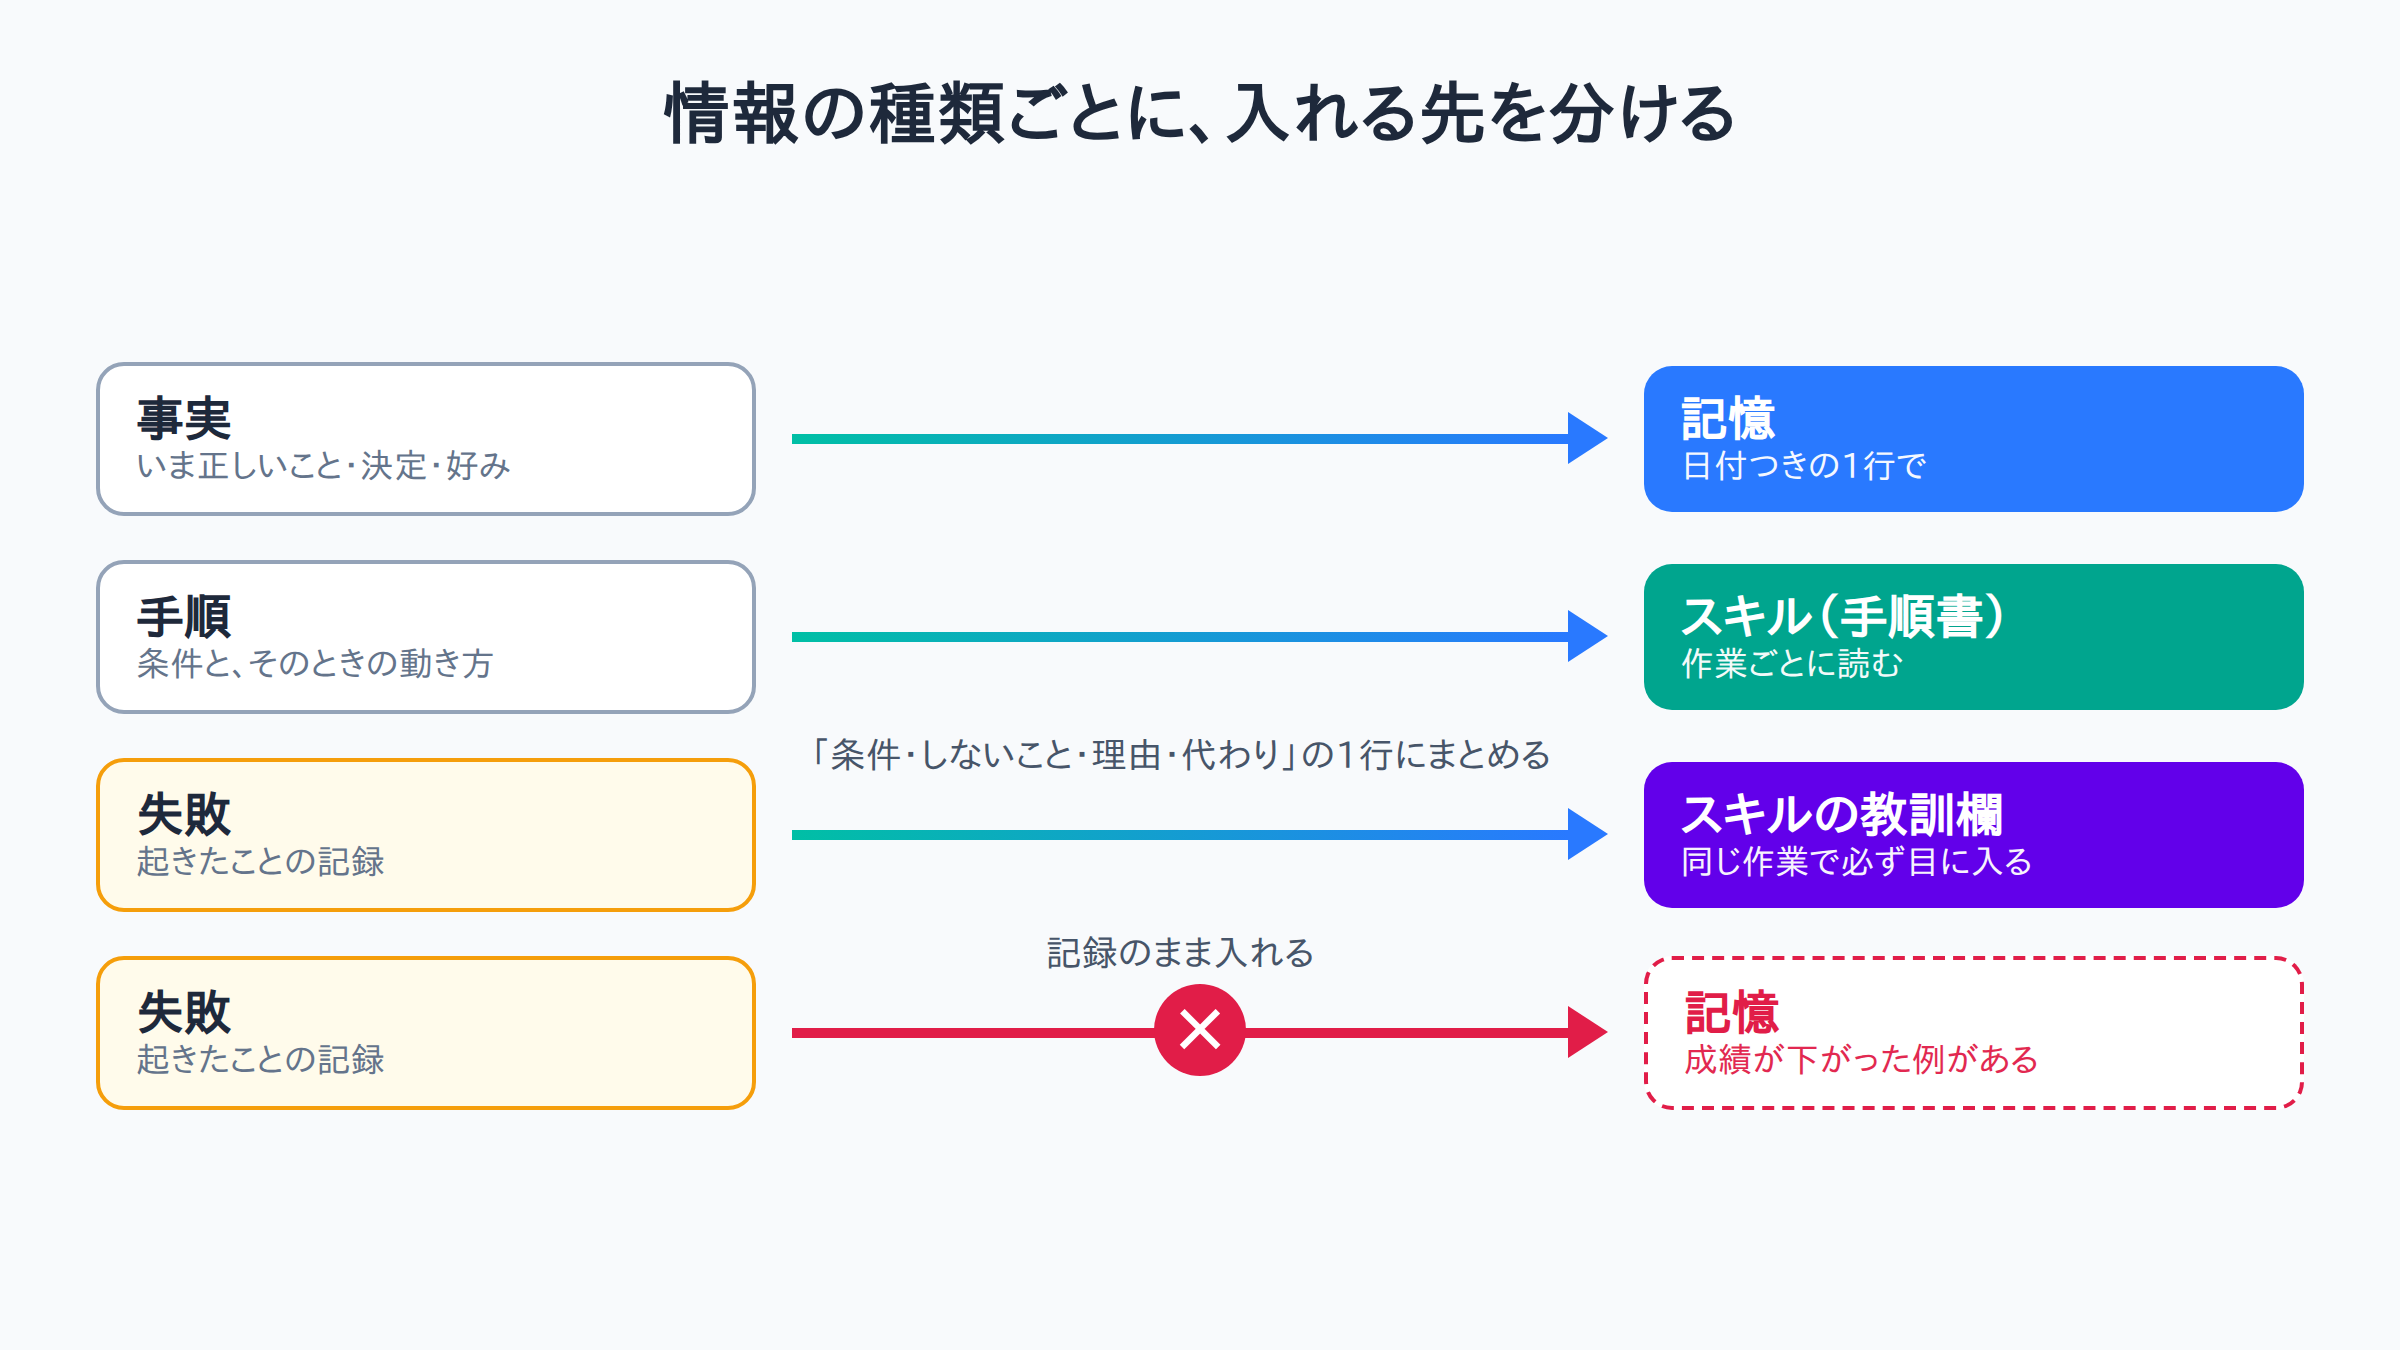
記憶とスキル(手順書)は、入れるものを分けます。記憶には事実を、スキルには手順を書きます。
2025年末に47人の研究者がまとめた AI エージェントの記憶のサーベイ(Memory in the Age of AI Agents)も、記憶を「事実の記憶」と「経験の記憶」に分けて整理しています。混ぜると、事実を知りたいときに手順が、手順を知りたいときに事実が出てきてしまいます。
私たちの基盤では、たとえば次のように分けました。
- 記憶:「論文の調査では、ある検索の道具は社内の安全設定で止められる。別の検索の道具なら使える」(いま正しい事実)
- スキル:「ブログ執筆は、構成 → 骨格の承認 → 本文 → 下書きで投稿、の順に進める」(手順)
- スキルの教訓欄:「この条件のときは、これをしない」(失敗から作った注意)
失敗から作った注意は、記憶ではなく、その作業のスキルに書き足します。同じ作業をするときに必ず目に入るからです。
入れ先を分けるだけで、記憶は「いま正しいこと」の短い一覧になります。
覚えるのは3つだけ:好み・コードから分からない事実・置き換わった事実
記憶に書くのは、「オーナーの好みと決定」「コードや説明書からは分からない運用の事実」「置き換わった事実」の3つに絞ります。
いちばん大事なのはオーナーの好みです。ICLR 2025 の PrefEval によると、会話の最初に伝えた好みを、10ターン(約3,000トークン)後にも守れていたモデルは、何も手を加えない状態ではほとんどが10%未満でした。GPT-4o の場合、そのままでは 7% でしたが、答える直前に「伝えられた好みを思い出して」と一言添えると 98% まで戻りました。好みは会話の中に置いておくだけでは守られず、必要なときに目の前に出し直す必要があります。記憶として取り出して渡すのは、そのための仕組みです。
2つ目は、コードや README を読めば分かることを書かない、ということです。AGENTS.md(エージェント向けの説明ファイル)の効果を測った研究では、リポジトリの概要を書いても、AI が目的のファイルに早く着くことはありませんでした。書く価値があるのは、ログインの状態や外部サービスのくせのように、コードを読んでも分からない事実です。
3つ目は、事実が変わったときの扱いです。ICLR 2026 の MemoryAgentBench では、「古い事実を新しい事実で置き換える」力が、どの手法でも弱いと報告されています。また LongMemEval(ICLR 2025)では、記憶に日付を付けて時間で絞り込むと、時間に関する質問で取り出しの正確さが上がりました。そこで、置き換わった事実には日付と「旧:」を付けて書くことにしました。
反対に、コードの構造や行番号、「実装済み」「残り」のような進み具合、一度きりの作業結果、失敗の生ログは覚えません。どれも、すぐ古くなるか、別の場所にすでに記録があるものです。
記憶は「AI がほかでは知りようのないこと」だけにすると、少ない行数でよく効きます。
毎回は書かない。結果が分かってから書く
記憶は、会話のたびに書き足すのではなく、作業の結果が分かってから書きます。
ACL 2026 で発表された Experience-Following の研究では、記憶を全部足していく方式だと、誤りが次の作業に引き継がれ、性能が下がり続けました。長く使うほど良くなったのは、足すものを選んでから入れる方式(厳しく選ぶ方式や、結果に点数を付けて選ぶ方式)でした。また、2026年10月に出た RBC という研究では、AI が自分で書いた教訓メモは、同じ手順で作っても出来にばらつきがあり、メモ無しより最大 69.6 ポイント悪くなることがあると報告されています。
結果が出る前の記憶は、正しいかどうか分かりません。正しいと分かってから書けば、誤りを記憶に入れずに済みます。
例外は、オーナーがはっきり言った好みや決定です。これは正解そのものなので、言われたその場で書きます。
書くのは「確かめてから」。これだけで、記憶に誤りが積み上がるのを防げます。
AI が自分で作った記憶やスキルは、確かめるまで下書きにする
AI が自分で作ったスキルは、人が確かめるまで使わせません。
87の課題で比べた SkillsBench では、人が整えたスキルを渡すと合格率が平均 33.9% から 50.5% に上がりました。ところが、AI が自分で書いたスキルを渡すと、スキル無しより悪くなりました(Claude Code と Opus 4.7 の組み合わせで −8.1 ポイント、Codex と GPT-5.5 で −11.3 ポイント)。論文は原因として「作ったのに使われない」「書くことに手間を取られる」「自信を持って間違った中身を書く」を挙げています。
ただし、この実験の自作スキルは「課題を解く前に、経験なしで書いたもの」です。作業のあとで振り返って書くスキルとは条件が違います。それでも「中身が正しいか確かめていない」点は共通しているので、私たちは確かめるまで下書きにすることにしました。
人が整えたスキルは効き、確かめていない自作スキルは害になりうる。だから、間に「確かめる」を挟みます。
自社の AI 社員に当てはめてやったこと
ルールを決めたあと、今ある記憶を数え直し、ルールを社内基盤の仕組みに組み込みました。ここからは、その中身と、まだ分かっていないことを紹介します。
記憶 757 行を数え直した
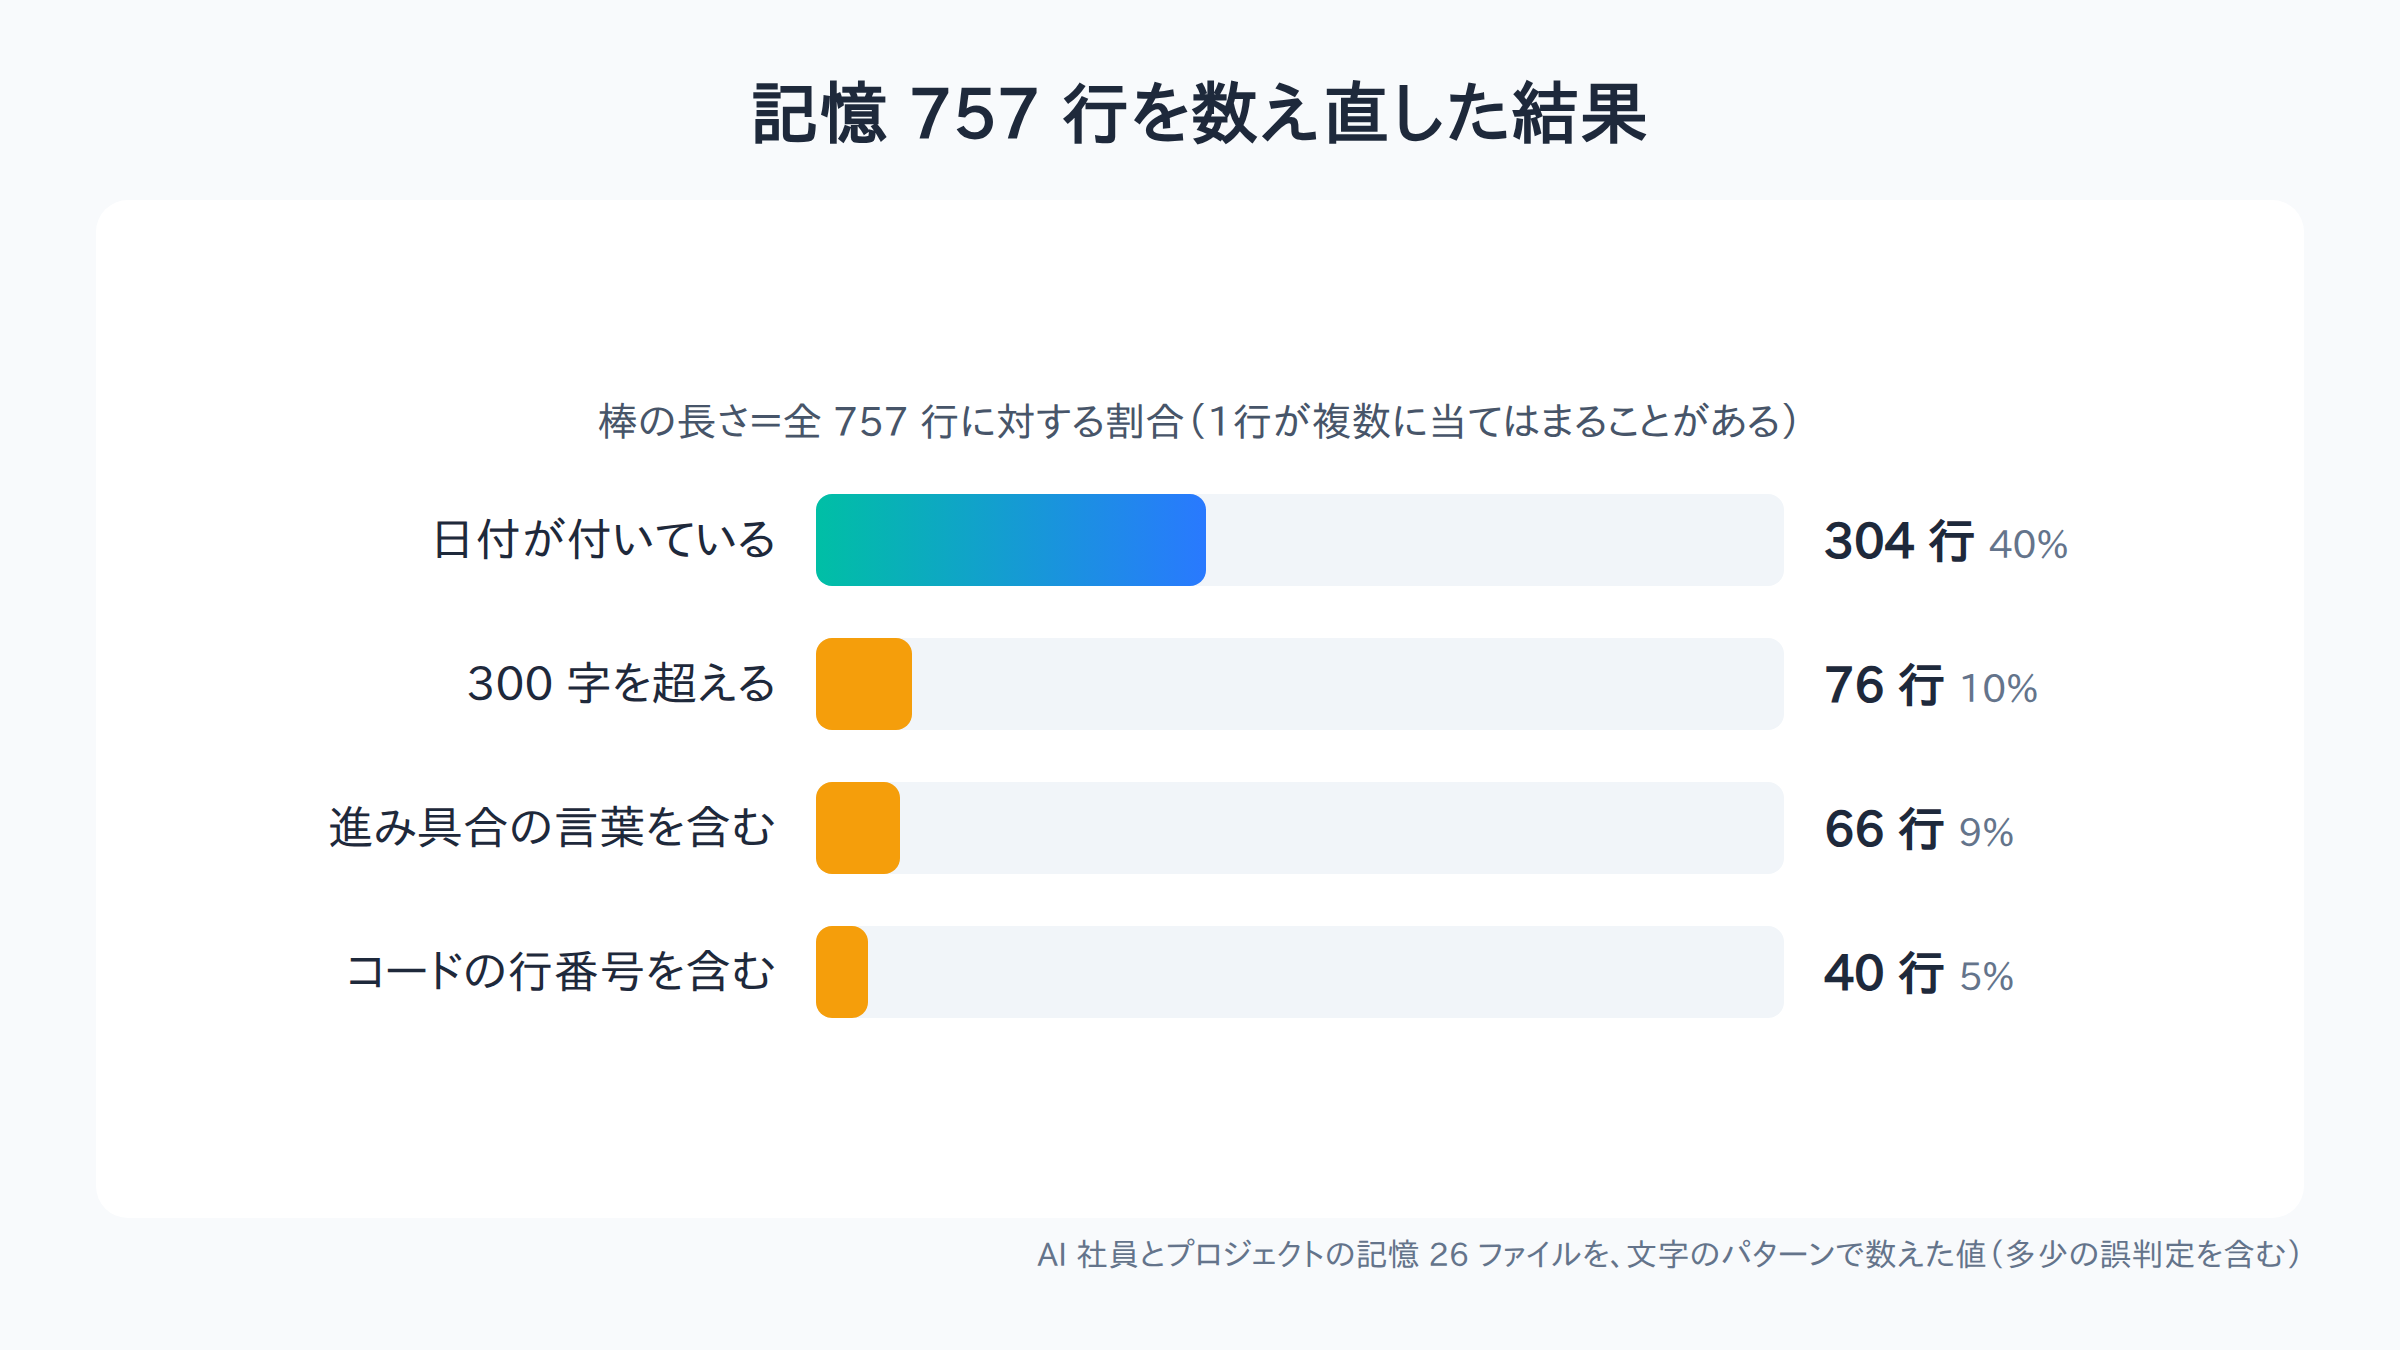
まず、AI 社員全員分とプロジェクトごとの記憶を数えました。26 ファイル、757 行ありました。
- 日付が付いている行:304 行(40%)
- 300 字を超える行:76 行(10%)
- コードの行番号を含む行:40 行(5%)
- 「実装済み」「残り」など進み具合の言葉を含む行:66 行(9%)
文字のパターンを当てて数えただけなので、多少の誤判定は含みます。それでも、日付の無い行が半分以上あり、すぐ古くなる行番号や進み具合の行も混ざっていることが分かりました。
長い行の問題は、枠を食うことです。私たちの基盤では、1回の作業に差し込む記憶を、関係の深い順に最大6行・合計1,500字までにしています。300 字の行が1本あると、それだけで枠の2割を使います。ReasoningBank でも、取り出す記憶は1件のときがいちばん成績が良く、増やすほど下がりました。数より、関係の深さと短さが大事です。
数えてみると、直すべき行がどこにあるかがはっきりします。
1行の書き方をテンプレートにした
記憶の1行は、次の形で書くことにしました。
[YYYY-MM-DD] 事実1つ(または「条件 → しない/する」1つ)。理由を一言。(出典)[旧:置き換えた内容]1行に事実は1つ、目安は150字以内です。詳しい中身は、元の記録の場所を出典に書いて、そちらで読めるようにします。LongMemEval でも、要約した事実だけを保存すると情報が落ち、元の記録を残して事実を「探すための手がかり」に使う方式が効いていました。
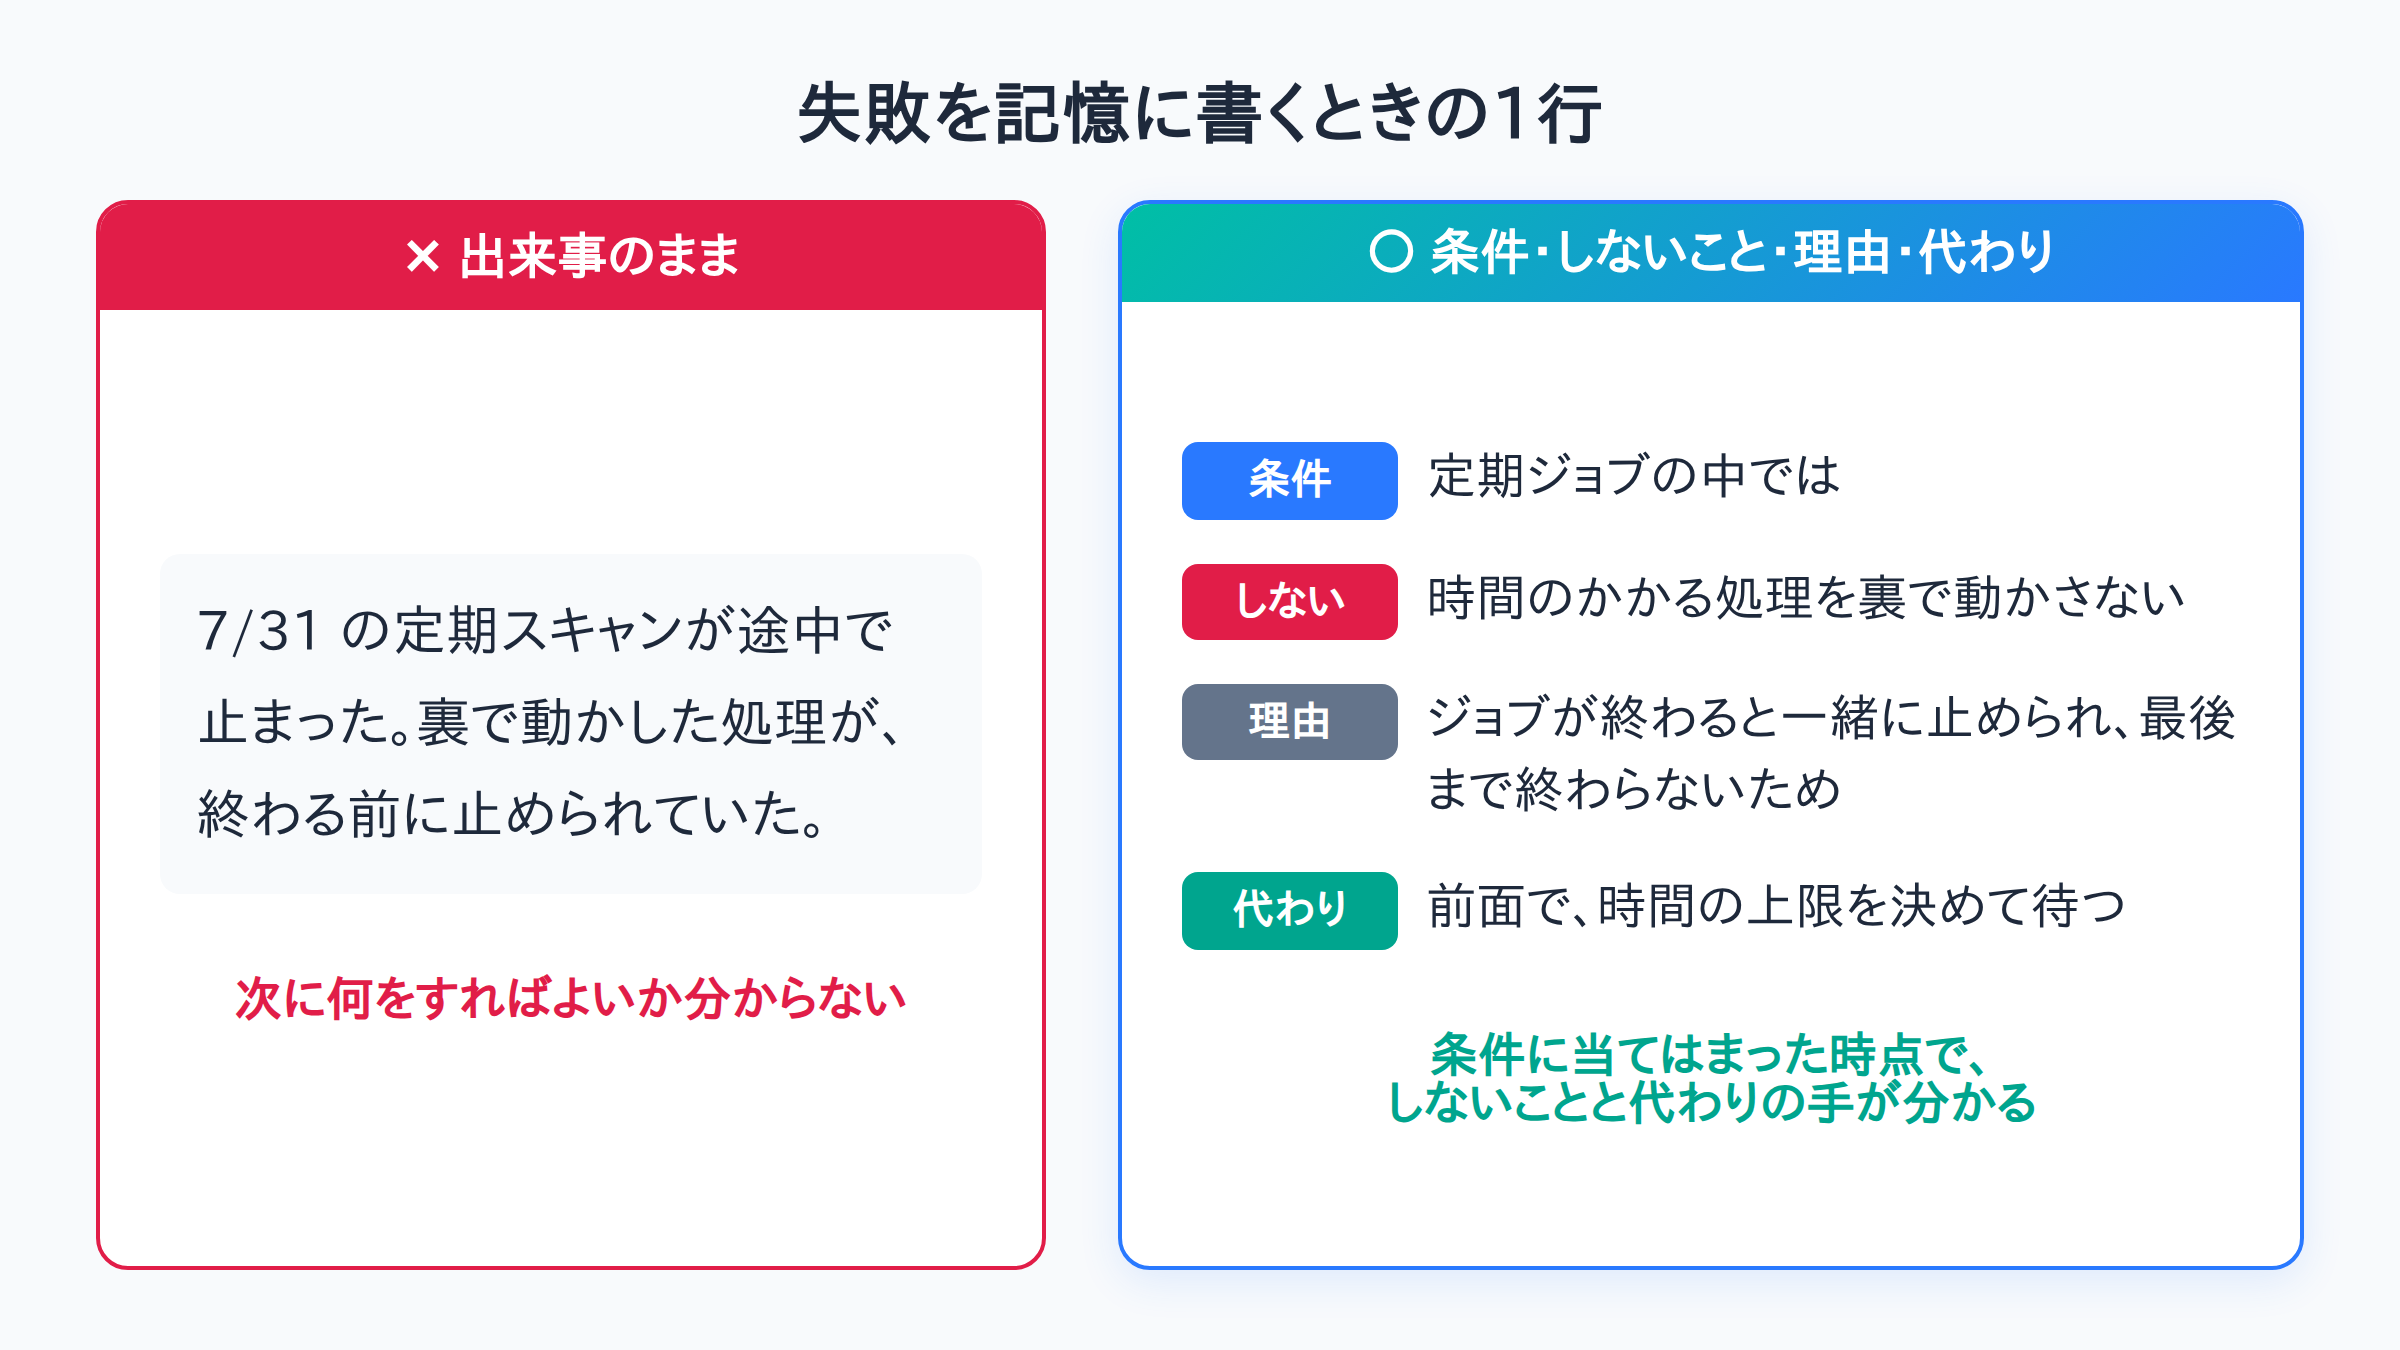
失敗から書くときは、出来事ではなく「条件・しないこと・理由・代わり」にします。私たちの基盤で、定期の調査ジョブが3日続けて途中で止まったときの例です。
- ✕「7/31 の定期スキャンが途中で止まった。裏で動かした処理が、終わる前に止められていた」(出来事のまま)
- ○「定期ジョブの中では、時間のかかる処理を裏で動かさない。ジョブが終わると一緒に止められ、最後まで終わらないため。代わりに前面で、時間の上限を決めて待つ」(条件・しないこと・理由・代わり)
✕の書き方では、次に同じ条件になったとき、何をすればよいかが分かりません。○の書き方なら、条件に当てはまった時点で、やってはいけないことと代わりの手が分かります。
形を決めておくと、誰が書いても、あとで読み返しやすい記憶になります。
指示文に基準を入れ、自動で作るスキルを承認制にした
ルールは文書に書くだけでなく、AI 社員が動く仕組みに組み込みました。やったことは4つです。
- AI 社員に毎回渡す指示文に、「覚えるもの3つ・覚えないもの・1行の書き方」を入れた。
- AI 社員が作業のあとに自分で作るスキルを、最初は「下書き」にした。下書きは誰にも渡されず、オーナーが画面で承認したものだけが使われる。
- 記憶の棚卸しの画面で、300 字超・行番号入り・進み具合の言葉を含む行を「書き直し候補」として出すようにした。仕組みを入れた翌日に棚卸しを回すと、候補は 111 行だった。
- 記憶の行ごとに「作業に差し込まれた回数」と最後の日時を数え、90 日差し込まれていない行を、消す候補として出すようにした。
承認制にしてから2026年10月24日までに、AI 社員が自分で作ったスキルは 10 本ありました。10 本とも下書きのまま、承認を待っています。確かめていないスキルが、そのまま AI 社員に渡ることはなくなりました。
ルールは、仕組みに入れて初めて毎回守られます。
まだ分かっていないこと
この取り組みで、まだ分かっていないことも書いておきます。
- 記憶の書き方を変えたことで、AI 社員の仕事が良くなったかは、まだ測っていません。測るには、同じ作業を「その記憶あり/なし」で比べる必要があります。
- 数えているのは「記憶を差し込んだ回数」です。差し込んだ記憶が実際に役に立ったかどうかは、この数からは分かりません。
- 「〜しない」型が効くという結果は、査読前の論文1本だけです。
- 使った論文の多くは英語の課題での実験です。日本語の社内業務で同じ大きさの効果が出るかは確かめていません。
効果が測れたら、続きの記事で報告します。
自社で始めるなら、まず1行のテンプレートから
これから AI エージェントの記憶を整えるなら、まず1行のテンプレートを決めて、今ある記憶をそれに合わせて書き直すところから始めるのがおすすめです。
道具も仕組みもいらず、今日から始められます。書き直す途中で、「これは手順だからスキルへ」「これは進み具合だから消す」と、自然に振り分けができます。
そのあとに、AI が自分で作る記憶やスキルを下書きにする仕組みを入れます。私たちもこの順番で進めました。
小さく決めて、仕組みに入れて、効いたかを測る。記憶の設計も、この順番で十分です。
まとめ
- 失敗と禁止事項だけを書く記憶は、おすすめできない。教訓は成功と失敗の両方から作ると効き、失敗を記録のまま溜めると成績が下がった。
- 記憶には事実、手順はスキルに分ける。失敗から作った注意は、その作業のスキルに書く。
- 覚えるのは「オーナーの好みと決定」「コードから分からない運用の事実」「置き換わった事実(日付つき)」の3つだけ。
- 記憶は毎回書かず、結果が分かってから書く。オーナーがはっきり言ったことだけは、その場で書く。
- AI が自分で作った記憶やスキルは、確かめるまで下書きにする。
記憶と並んで AI エージェントの働きを左右するのが、スキル(手順書)の渡し方です。どのスキルをどう選んで渡すかは、関連記事「AIエージェントに渡すスキルはどう選ぶ?検索(BM25)をやめて、モデル自身に選ばせた理由と実例」で詳しく紹介しています。AI エージェントに何をさせてよいかの線引きは「AIエージェントの権限管理はどう設計する?大手2社の事故と、自社で権限を絞って分かった残りの課題」もあわせて読んでみてください。