「AI の機能を業務に入れてみたけれど、本当に効いているのか分からない」「なんとなく良さそうなので、そのまま使い続けている」。AI を業務で使い始めると、こうした状態になりがちです。世の中に出ている話も、ほとんどが「入れてうまくいった話」で、効果を測って判断した話はあまり見かけません。
この記事では、社内の AI 機能を2週間 A/B テストした結果と、「差なし」という結果から「やめる」と決めた理由を紹介します。あわせて、次に AI 機能を試すときに、試す前に出しておくべき数字も説明します。
アストラルコードでは、AI 社員(AI エージェント)が定期業務やチャットで働く社内基盤を自社で運用しています。この記事は、2026年10月にその基盤で行った14日間・138件の比較と、そのあと関係するコードを消すまでの記録をもとに書いています。以前の記事「AIエージェントに渡すスキルはどう選ぶ?」で「比較中」と書いた件の結果報告でもあります。
AI 機能の効果は A/B テストで測れる。「差なし」も結果のひとつ
AI 機能が効いているかどうかは、A/B テストで確かめられます。そして「差があるとは言えない」という結果も、判断の材料になる立派な結果です。
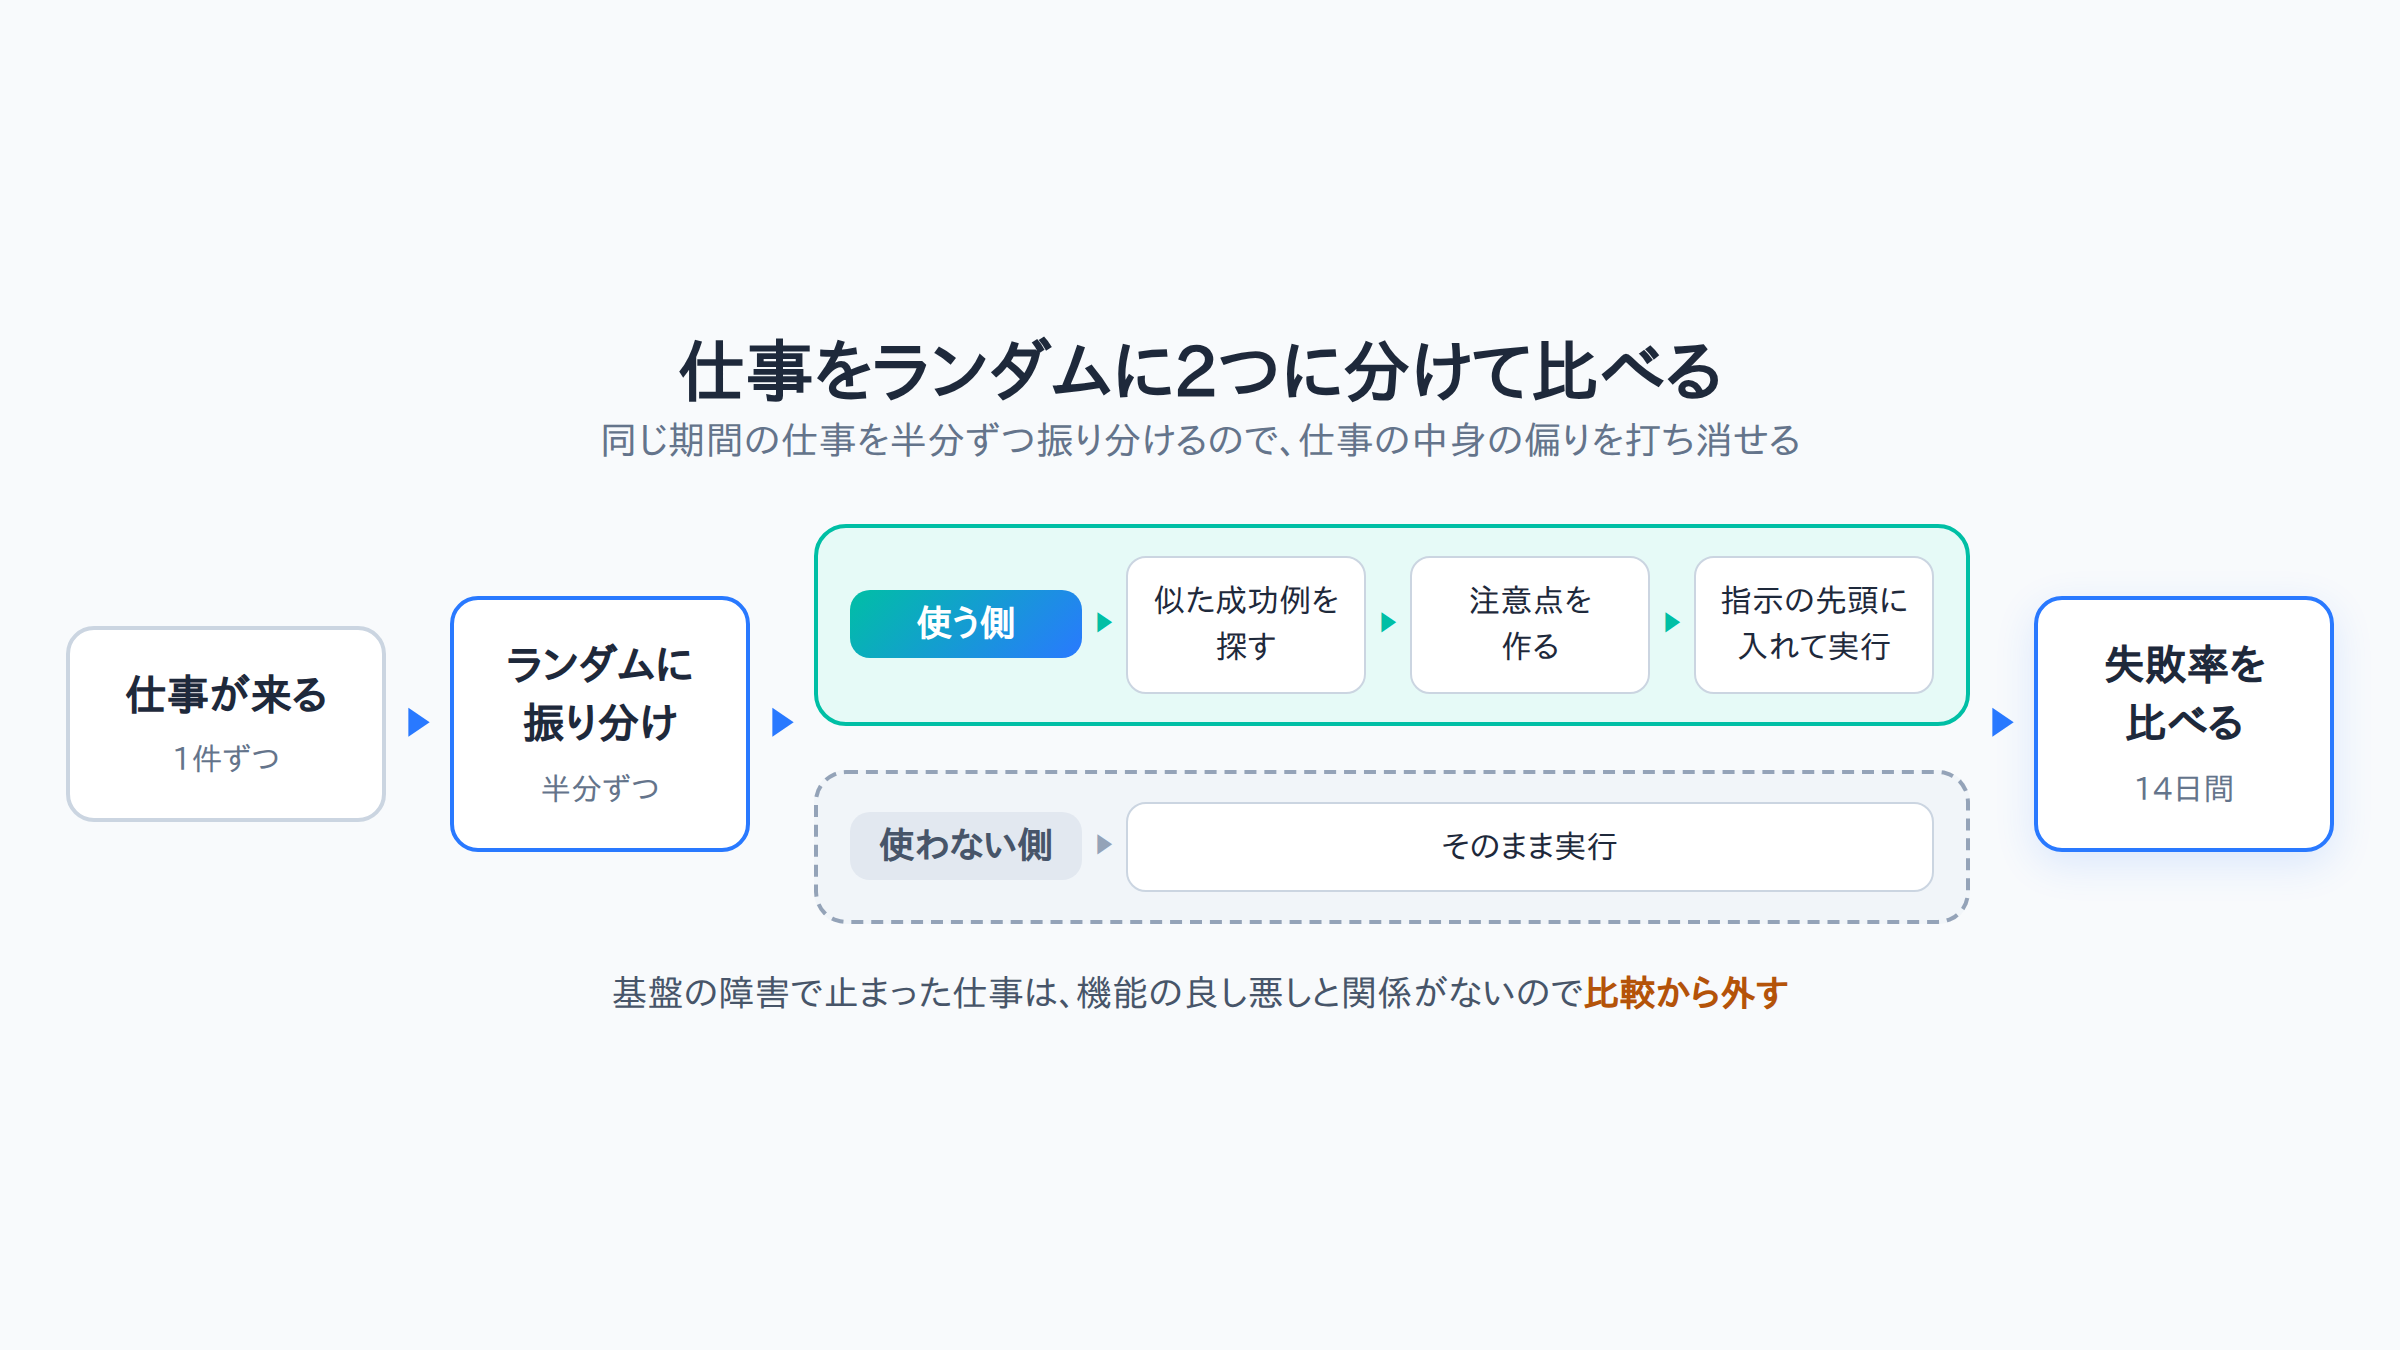
AI の出力は毎回少しずつ違い、頼む仕事の中身も日によって変わります。そのため、使う前と後を見比べるだけでは、機能のおかげなのか、たまたま簡単な仕事が多かったのかを分けられません。同じ期間の仕事をランダムに2つに分ければ、仕事の中身の偏りを打ち消して比べられます。
以下、私たちが実際に試したものと、その結果です。
試したもの:仕事の前に、似た成功例から指示を作る仕組み(JitMem)
試したのは、Salesforce の研究「JitMem」をもとにした仕組みです。
AI 社員が仕事を始める前に、過去にうまくいった似た仕事の記録を最大3件探します。見つかったら、軽いモデルに「今回の仕事で気をつけること」を短くまとめさせ、指示の先頭に入れます。論文では、記録を保存するときではなく、使うときに仕事に合わせてまとめ直すほうが成功率が高かったと報告されています。
私たちが解きたかったのは、「AI 社員が、前にうまくいった似た仕事のやり方を活かせていない」という問題でした。
論文で効果が出ていても、自社の仕事で効くかどうかは別です。だから、入れるのと同時に比べる仕組みも作りました。
比べ方:仕事ごとにランダムに「使う」「使わない」に分けて14日間
仕事が1件来るたびに、ランダムに半分ずつ「使う側」と「使わない側」に振り分けました。
見る数字(KPI)は失敗率です。失敗の記録が付いた仕事の数を、仕事の数で割ったものです。仕事ごとに「どちらの側か」「指示が入ったか」「指示を作るのに使ったトークン」を1行ずつ記録し、失敗したかどうかは失敗の記録から読みました。
AI 側の不具合ではなく、動かしている基盤の障害で止まった仕事(5件)は、機能の良し悪しとは関係がないので比較から外しました。
ランダムに分けて、同じ期間・同じ数え方で比べる。比べ方の形としては、ここまでは問題ありませんでした。
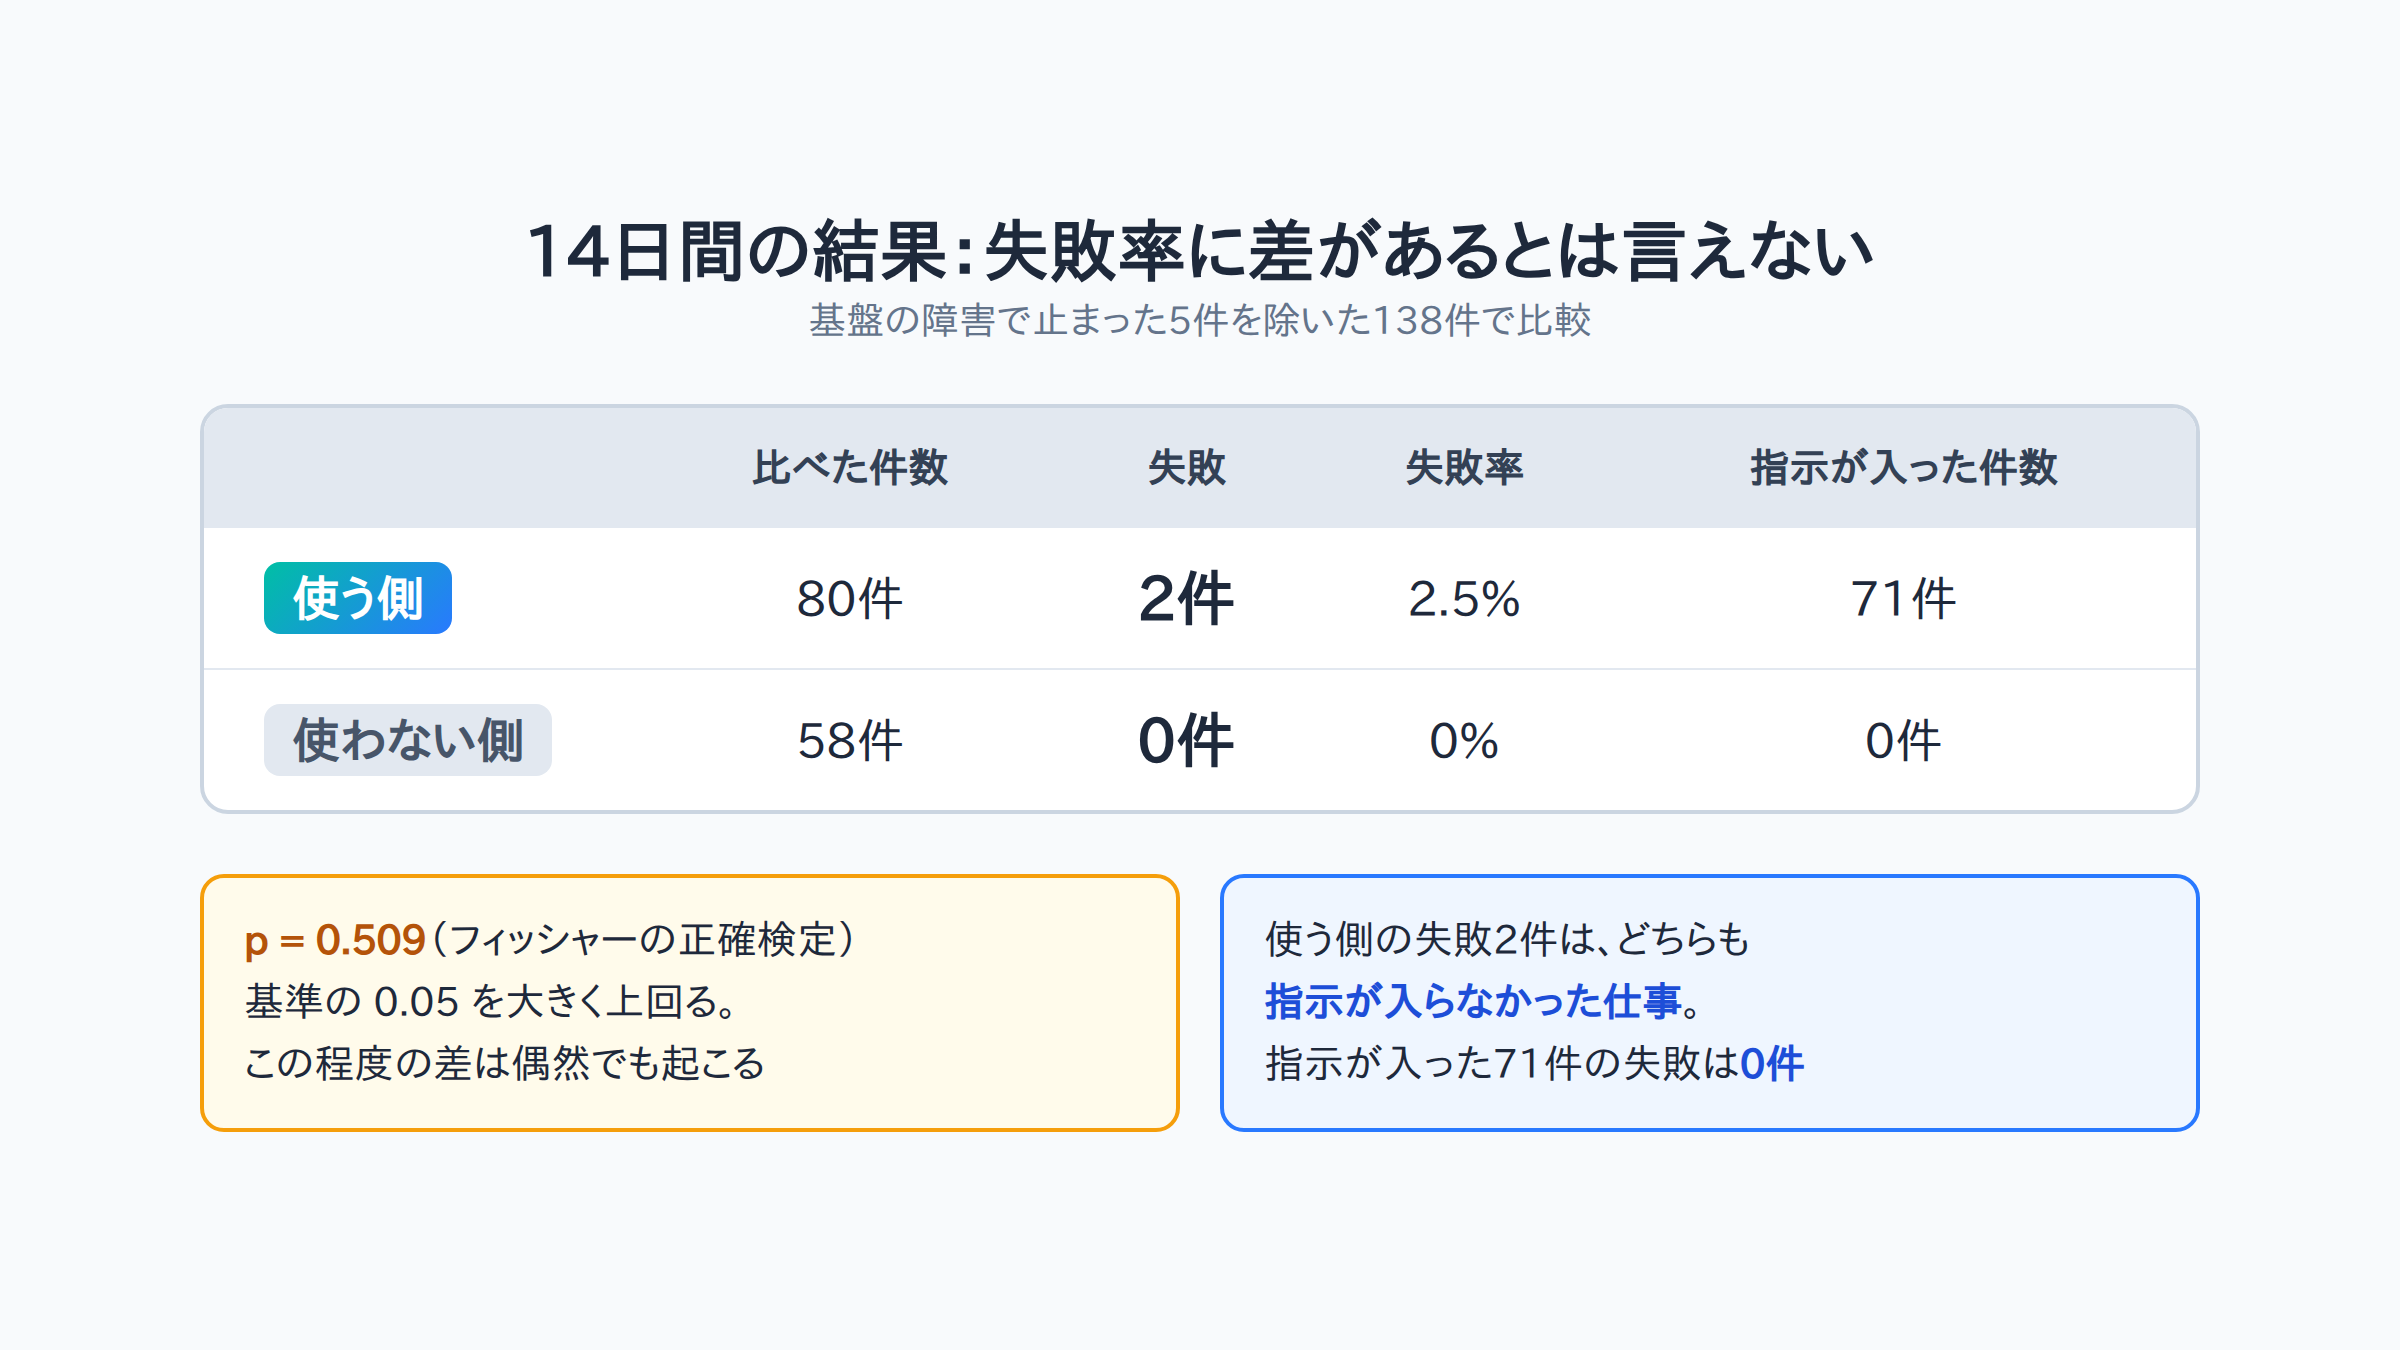
結果:失敗は 2/80 と 0/58。差があるとは言えなかった
結果は「差があるとは言えない」でした。
件数が少ないときに2つの割合の差を確かめる方法(フィッシャーの正確検定)で調べると、p 値は 0.509 でした。p 値は「本当は差がないのに、たまたまこのくらいの差が出る確率」の目安です。よく使う基準の 0.05 を大きく上回っていて、この程度の差は偶然でも十分に起こります。
数字だけ見ると、使う側のほうが失敗が多く見えます。ただ、失敗した2件の中身を見ると、どちらも「似た成功例が見つからず、指示が入らなかった仕事」でした。つまり、仕組みを使う側に振り分けられたものの、実際には何も足されていない仕事です。指示が実際に入った71件では、失敗は0件でした。
「使うと失敗が増えた」とも「使うと失敗が減った」とも言えない。これが2週間の正直な結果です。
「やめる」と決めた3つの理由
私たちは、この仕組みを「続ける」のでも「延長して測る」のでもなく、「やめる」と決めました。関係するコードも消しています。理由は次の3つです。
理由1:効果を示す証拠がない
まず、効いているという証拠がありません。
害も見つかっていないので、「続ける」も筋は通ります。ただ、効いているか分からない機能を常に入れておくと、あとで何か問題が起きたときに、原因の候補が1つ増えます。仕組みが複雑になるぶん、ほかの改善もしにくくなります。
効果が見えないものを、なんとなく残すことはしない。これが1つ目の理由です。
理由2:延ばしても答えが出ない
2つ目の理由は、期間を延ばしても、この測り方では答えが出ないことです。
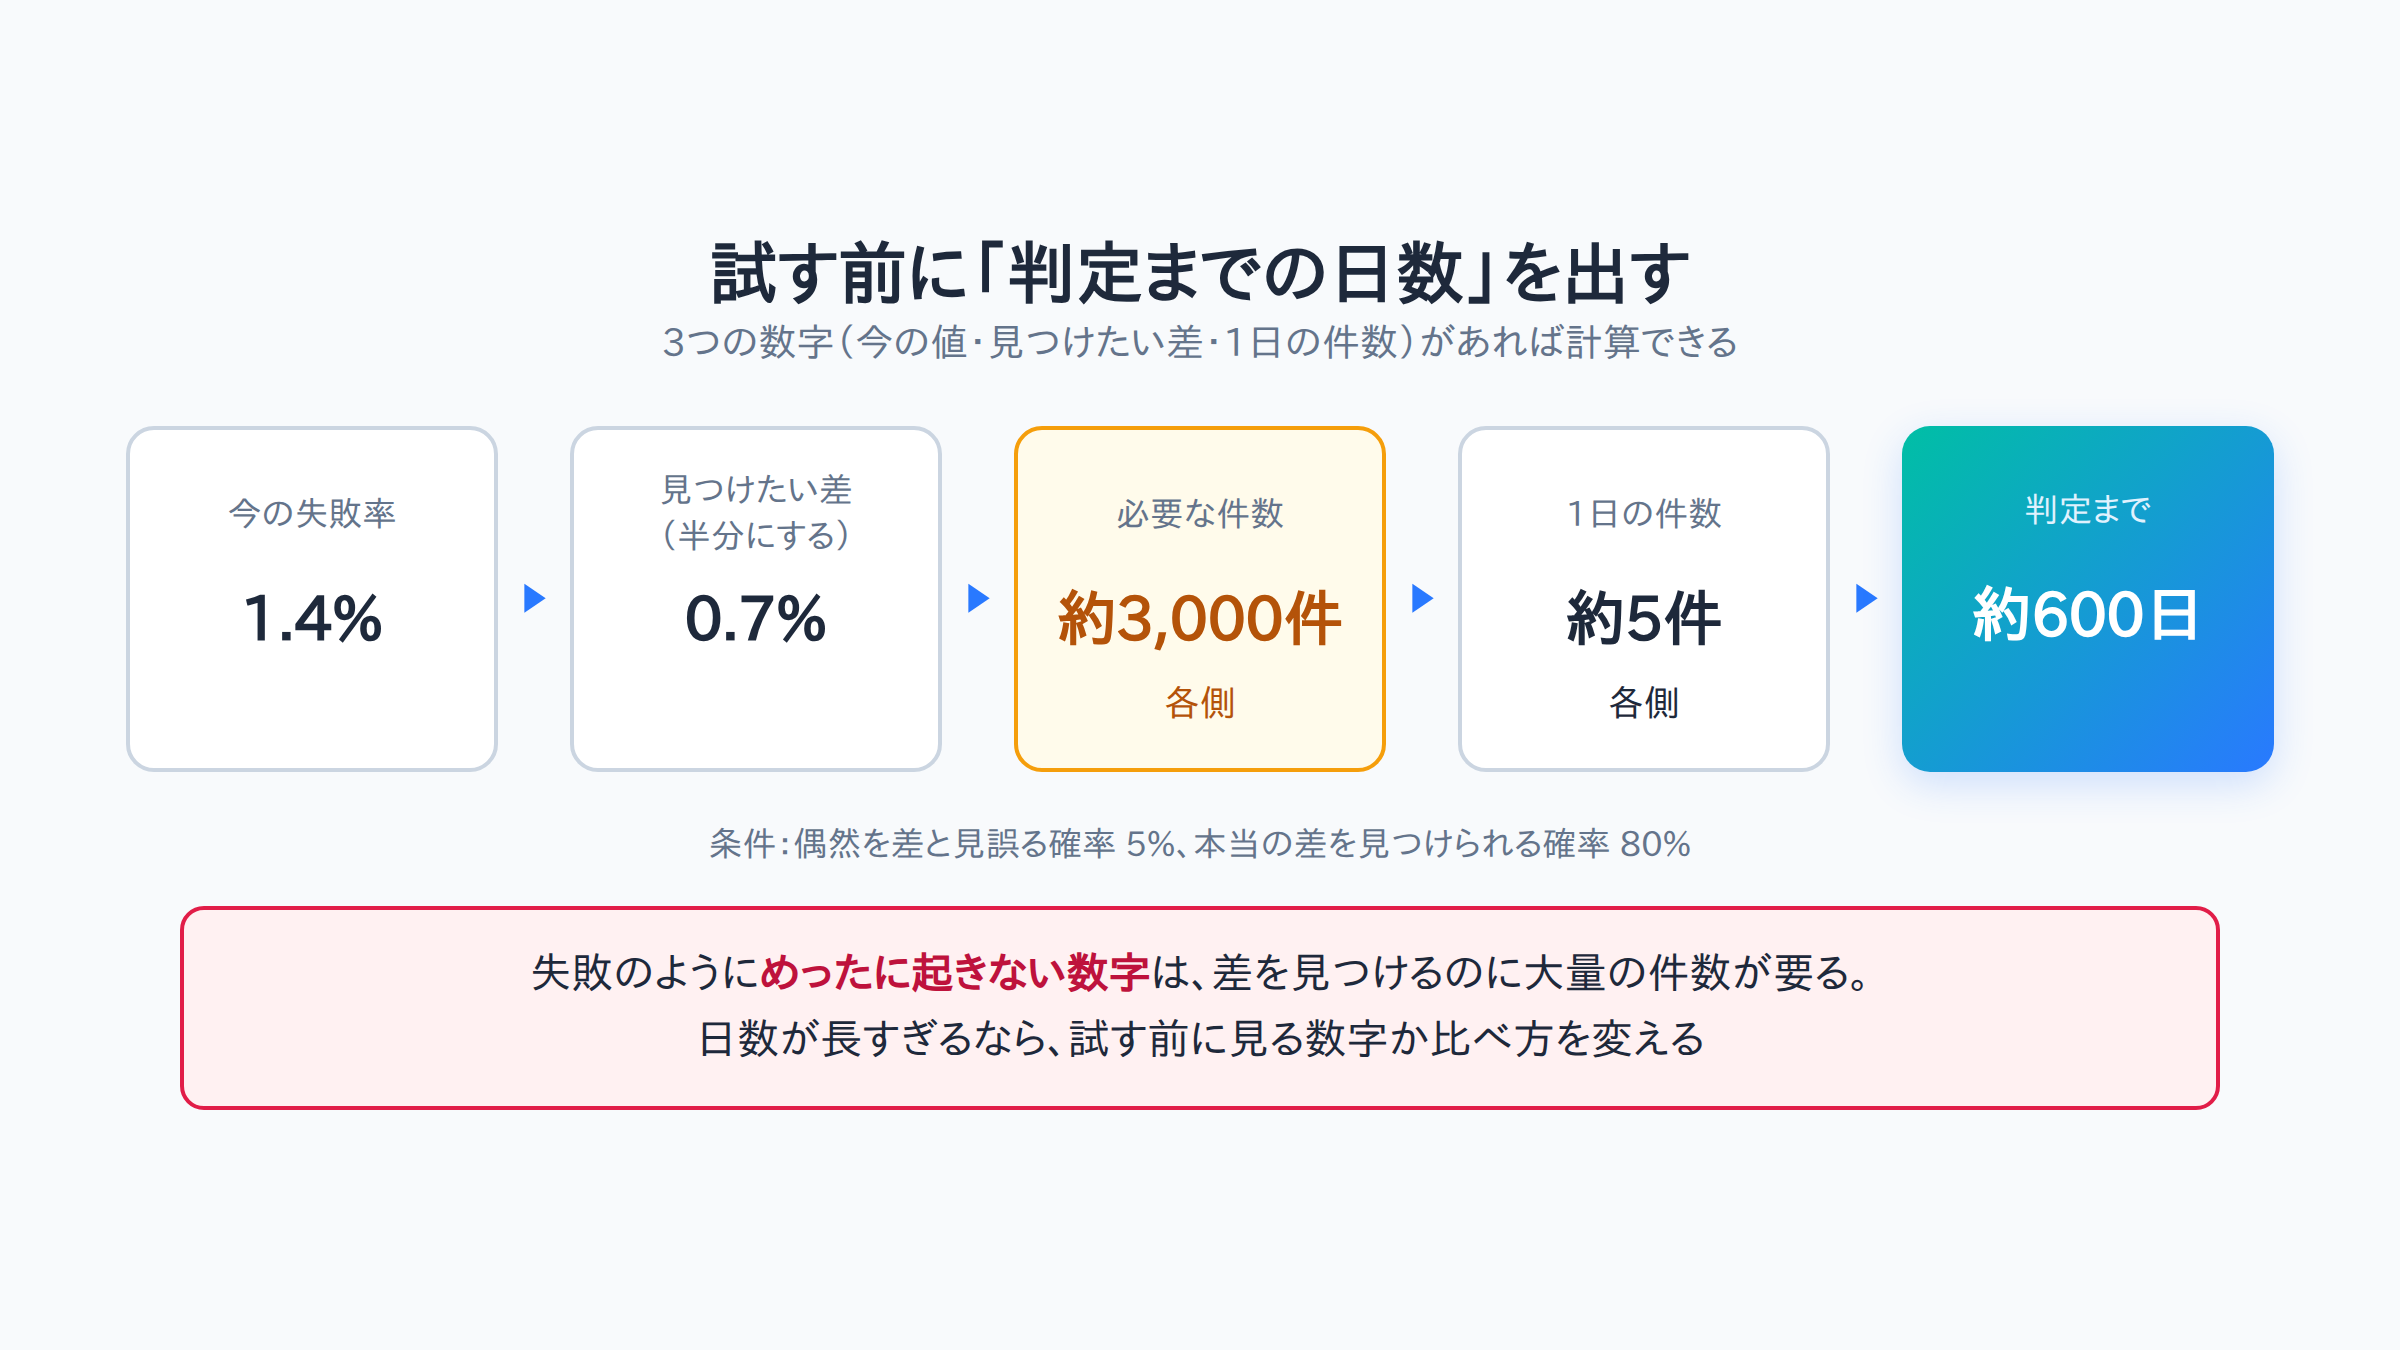
失敗がもともと少なすぎました。2週間・138件で失敗は2件、失敗率は約1.4%です。仮に「失敗を半分(約0.7%)に減らせたら効果あり」と見るとします。この差を、よく使う条件(偶然を差と見誤る確率5%、本当の差を見つけられる確率80%)で見つけるには、両方の側でそれぞれ約3,000件の仕事が要ります。
いまの仕事の量は1日約10件、片側で約5件です。約3,000件を集めるには約600日、2年近くかかります。2週間延ばしても失敗は数件増えるだけで、判断は変わりません。
正直に書くと、この「必要な件数」と「判定までの日数」は、試す前ではなく、試し終わったあとに計算しました。試す前に計算していれば、失敗率で比べる設計そのものを見直せたはずです。ここが今回いちばんの反省点です。
理由3:費用は小さいが、仕事のたびに毎回かかる
3つ目の理由は、小さいとはいえ、仕事1件ごとに必ず負担が足されることです。
指示を作るために、使う側では1件あたり約1.1万トークンと約10秒が足されていました。2週間の合計では約93万トークンです。
金額としては大きくありません。それでも、効果が分からないものに、仕事のたびに時間とトークンを払い続ける理由はありません。仕事の量が増えれば、負担も同じだけ増えます。
費用が大きいからやめたのではなく、効果が測れないものに払い続けないためにやめました。
次に AI 機能を試すときにやること
今回の結果から、次に AI 機能を試すときの進め方を3つ決めました。
試す前に「判定までの日数」を出す
試す前に、「どのくらいの期間で白黒がつくか」を計算します。
必要なのは、①見る数字の今の値、②どのくらいの差なら効果ありと見るか、③1日に何件たまるか、の3つだけです。この3つがあれば、必要な件数と日数は計算できます。計算した日数が長すぎるなら、試す前に見る数字か比べ方を変えます。
今回のように「試してみたけれど、そもそも答えが出ない設計だった」と後から気づくのは、2週間ぶんの時間とトークンの無駄です。
先に日数を出す。これだけで、答えの出ない試験は始める前に止められます。
失敗率のような数の少ない数字ではなく、件数が多く出る数字で見る
見る数字には、件数がたくさん出るものを選びます。
失敗のように、めったに起きない出来事の割合は、差を見つけるのに大量の件数が要ります。一方で、毎回の仕事で必ず数えられる数字なら、少ない件数でも差が見えやすくなります。
次の試験では、「やり直しの回数」や「人が差し戻した件数」のように、仕事ごとに数えられて、件数が多く出る数字で測る予定です。
「本当に知りたいこと」と「測れる数字」がずれていないかを、試す前に確かめることが大切です。
やめると決めたら、コードまで消して終わらせる
やめると決めたら、設定で止めるだけでなく、関係するコードも消します。
止めただけのコードは、読む人に「これは使われているのか」という迷いを残します。比べるために足した記録や、結果を報告する定期の作業も同じです。
今回は、仕組みの本体とそのテスト、呼び出している部分、記録を見るための入口、試験の結果を報告する定期の作業をまとめて消しました。判断の理由と数字は、施策の記録として別に残しています。
コードは消し、判断の記録は残す。こうしておけば、あとで「なぜやめたのか」を聞かれても答えられます。
まとめ
- AI 機能の効果は、仕事をランダムに2つに分ける A/B テストで測れる。「差があるとは言えない」も、判断に使える結果。
- 似た成功例から仕事の前に指示を作る仕組み(JitMem)を14日間・138件で比べた結果、失敗は 2/80 と 0/58 で、p = 0.509。差は見えなかった。
- 効果の証拠がないこと、延ばしても答えが出ないこと(判定まで約600日)、仕事のたびに負担が足されることから、やめてコードも消した。
- 次に試すときは、①試す前に判定までの日数を出す、②件数が多く出る数字で見る、③やめるならコードまで消して記録は残す。
AI 社員に過去の経験をどう渡すかは、この試験の前に作り直した「スキルの渡し方」や「記憶のルール」とつながっています。関連記事「AIエージェントに渡すスキルはどう選ぶ?検索(BM25)をやめて、モデル自身に選ばせた理由と実例」「AIエージェントの記憶に「失敗だけ」を書くと逆効果?査読論文で決め直した社内AIの記憶ルール5つ」もあわせて読んでみてください。
「入れた AI 機能が効いているか確かめたい」「試す前に、どう測るかを一緒に決めたい」という方は、お問い合わせからお気軽にご相談ください。